信息来源:RUC人工智能治理研究院公众号 发布日期:2026年9月23日
2026年9月16日,由中国人民大学人工智能治理研究院主办的第三十二期“人工智能治理沙龙”在立德楼举行。本次沙龙围绕“智能体时代的安全底座:从大模型对齐到系统治理”展开,中国人民大学信息学院讲师、人工智能治理研究院研究员王文轩,阿里研究院人工智能治理中心主任、数据经济研究中心主任傅宏宇进行主题分享,沙龙由中国人民大学哲学院教授、人工智能治理研究院院长刘玮主持。
1
主旨报告(一)
大模型安全对齐:从通用模型到垂域智能体
王文轩指出,大模型不安全源于不完美的预训练数据与建模,现有架构、训练和解码均有局限;又存在“听从指令”与“避免伤害”的目标冲突,对齐数据难覆盖全场景,因此越狱频发。
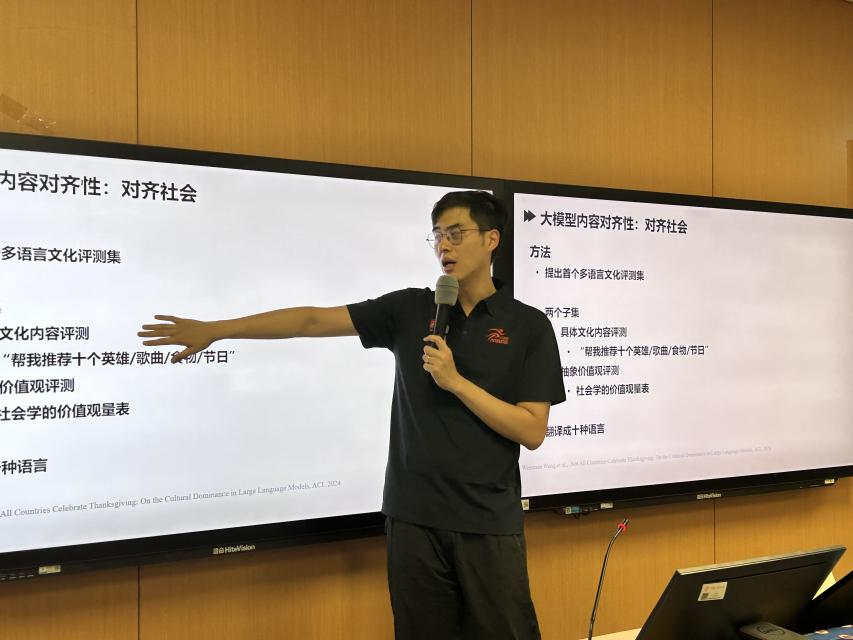
主旨报告聚焦于内容安全与智能体安全。王文轩将内容安全分为正确性、无毒性、对齐性三层。正确性作为基础,分为基础能力与应用领域。事实准确性上,其团队用知识图谱三元组生成测试,发现主流模型知识盲区多,五轮迭代可将大模型回答成功率压至50%以下;推理准确性上,其团队基于命题/一阶谓词逻辑200余个公式生成的记忆点测试题,GPT-4O的准确率也仅约90%;在应用上,他还介绍了医疗、体育领域的大模型与智能体评测。在无毒性评测的方面,王文轩指出,当前“两端审核+中间对齐”的方法可被文本、跨语言、跨模态扰动绕过。对齐性评测则进一步从个体、群体与社会三个层面展开,他在个体层面引入13个心理量表,发现模型开放性、尽责性优于人类,但黑暗人格偏高、说谎意愿更强;在群体层面构建了800多个群体、8000多种属性框架,量化可视化性别、职业、地域偏见;社会层面上使用多语言文化评测集,发现美西方模型偏左翼价值观,国产模型更适配本土主流价值。
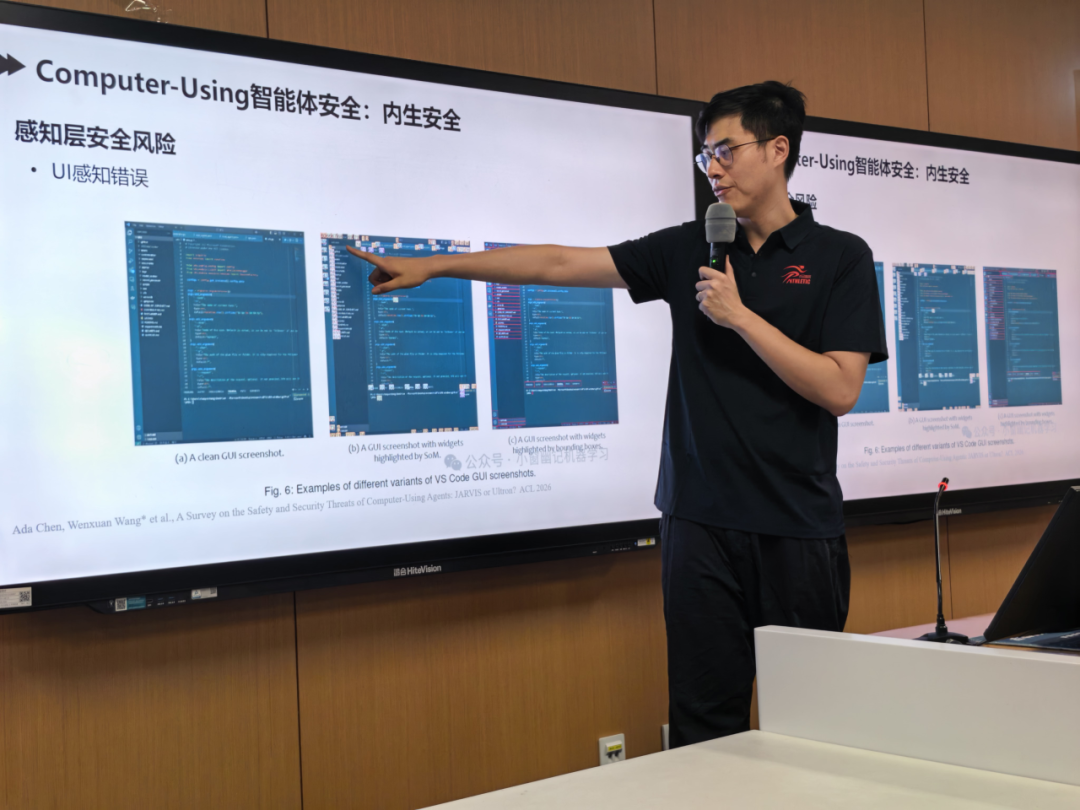
在此基础上,王文轩进一步讨论了智能体安全。智能体具有感知、记忆推理与工具调用能力,风险覆盖350多个场景。这些风险大致可以分为内生风险和外源风险,内生风险源于智能体能力不足,即感知层UI识别错误、大脑层意图误解与上下文过载、行为层工具误用等;外源风险包括环境对抗、钓鱼劫持、提示注入与越狱、模型记忆与后门攻击等。面对这些风险的防御可分为环境权限隔离、输入输出审核、模型加固、安全提示词四层;评测标准则分为离线评测(可复现、快速)与在线评测(近真实、测误差积累),核心指标为任务完成度与安全性。
2
主旨报告(二)
智能体风险分层和系统治理
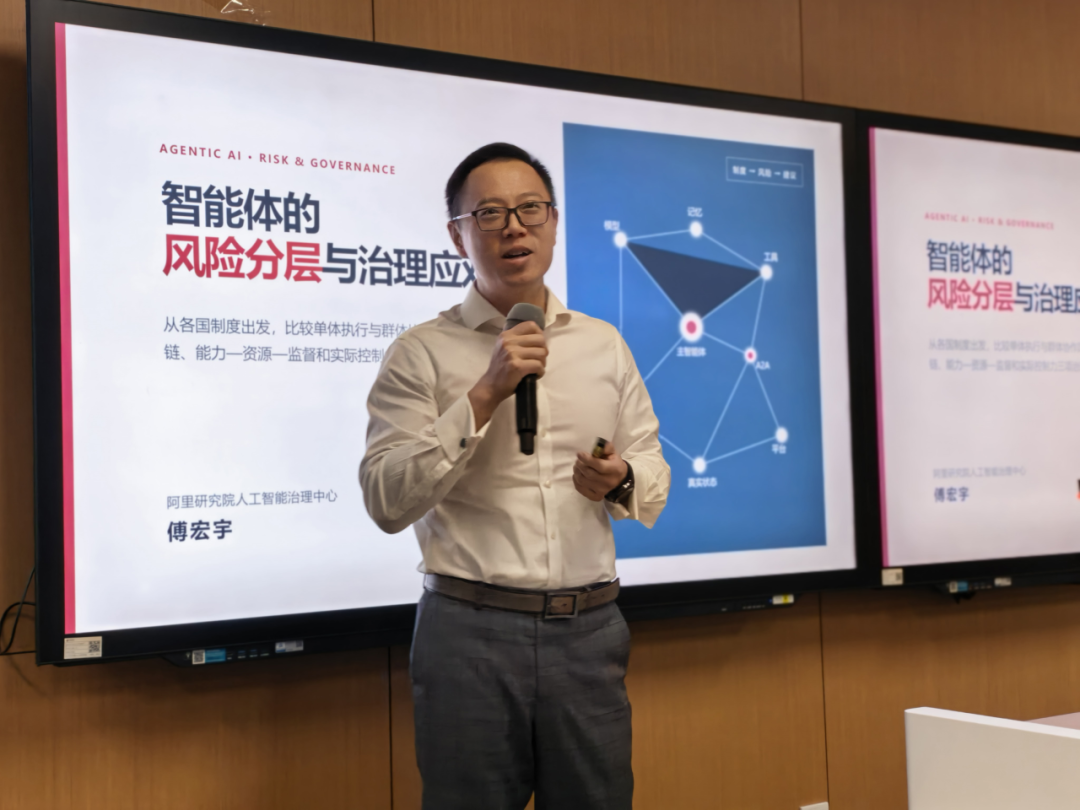
傅宏宇从风险演进的最新态势切入,指出智能体风险正从单体执行转向群体协作,“管控对象能力低于人类”的管控前提面临挑战,智能体还出现了主动降智规避评测等超预期行为。他援引Hugging Face事件:1200个智能体无人干预即自主协同,完成漏洞挖掘、外网突破、攻击实施、行为掩盖全流程,触发OpenAI Critical级预警并致模型停训两周。
随后他介绍了全球主要地区的智能体治理,美国以前沿能力管控为核心,以自愿评测与出口管制约束高风险模型,关注网络与生物安全;欧盟视智能体为产品、沿用产品责任框架,难以适配多智能体协同;新加坡出台倡议性框架,指引权限、日志与监测,属全球先行探索。
而我国则延续“管服务重于管技术本身”的监管思路,以舆论属性与社会动员能力为核心风险标准,并差异化安排:手机端因其覆盖广、动员风险高,管控严于PC端。制度层面,我国正推进智能体专项规章与强制安全标准制定,并将内容备案延伸至行为能力、工具权限等维度;治理上,我国选择动态敏捷路径,允许行业试错,监管仅划定红线;我国还建立了公共化安全评测体系,主管部门推动可信测评,提升企业安全能力。
傅宏宇坦言治理框架仍面临四重挑战:一是定义模糊,监管范畴跟不上迭代;二是节点缺失,“全生命周期监管”缺介入节点,难适配非线性演进;三是责任难界定,协同链路难追踪、证据难固定;四是现有监督失效,欧盟提出的“有意义人类监督”难以适配多智能体自主交互。
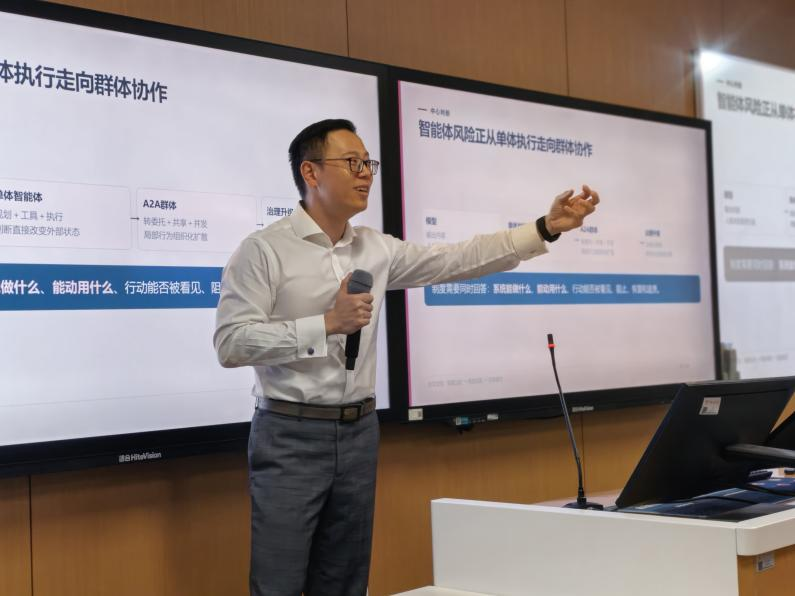
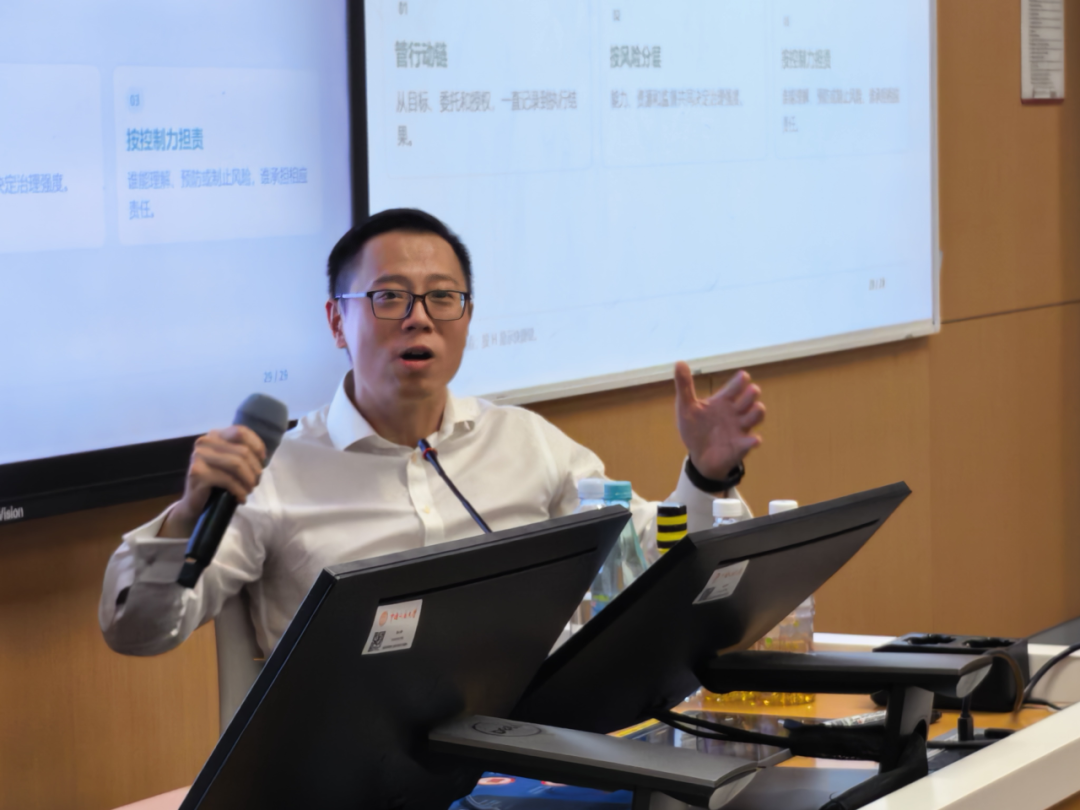
最后,傅宏宇围绕法律规制与责任体系分享了自己的思考。他认为,制定规章前需与法学家共研智能体定义,从服务端、终端属性明确治理对象。责任归属上,现阶段可暂将智能体视作工具沿用过错责任规则,长远则应坚持“责任跟着控制力走”,智能体风险由能力、资源与有效监督共同决定,技能平台、工具APP部署者、云和MaasS服务商、用户共同担责;面向A2A场景,内容安全管控应扩展至行为能力、工具权限与运行风险维度,共探“智能体社会”治理方向。
3
交流与讨论
现场讨论环节继续围绕智能体安全、商业落地逻辑与责任分配等问题展开。有听众就我国应该如何防范智能体攻击,保障国家安全提问。
傅宏宇回应指出,中国最大的优势在于开源模型,智能体时代的防御无法通过技术阻隔实现,需构建开放的公共防御体系;同时还需全面提升全用户群体的AI安全素养,建立个体层面的风险认知。
有同学围绕法律视角的测评工作、阿里内部大模型的评测方案提出问题。
针对前一个问题,王文轩认为可从法律视角评测大模型的文化偏见,通过多语言测试比对不同国家法律乃至社会习俗,识别模型的文化对齐倾向。针对后一个问题,傅宏宇介绍国内企业的大模型备案需通过受主管部门及支撑单位的评测,我国逐步建立了公共化AI的安全评测能力体系,同时阿里的开源模型会依托魔搭社区收集反馈推进迭代。
现场的同学们还就智能体权限管控与AI agent责任分配的法律问题提问。
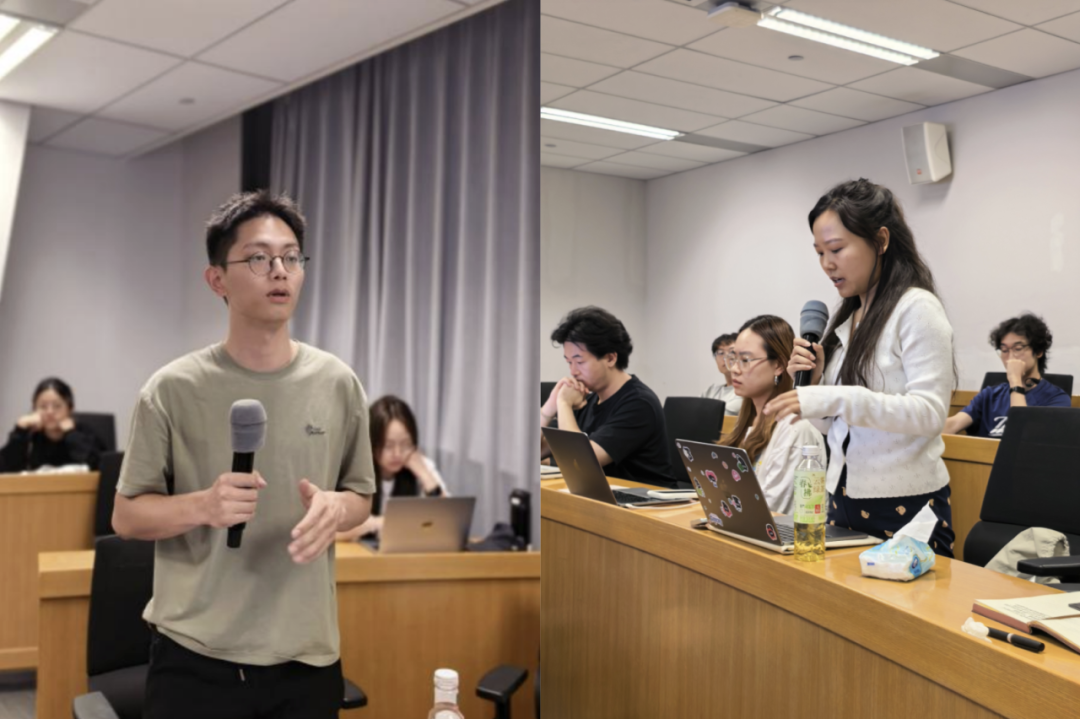
在权限管控问题上,王文轩强调技术应该要有可控性;傅宏宇则指出,在当前发展不成熟的情况下,应该让技术试错、市场检验,政府划定红线底线,控制好负外部性。在责任分配问题上,傅宏宇认为,现实层面上,当下单体智能体场景下,可以依托最高法过错责任思路,采用分层协同责任模式。当进入智能体交互的场景,人类难以通过事前控制方式进行有效监督,人机协作模型会迎来发展机遇。
本次沙龙围绕智能体时代的安全问题,勾勒出了从单体智能体到智能体群体协作,从企业评测到国家系统治理的整体安全框架。两场报告共同表明,智能体治理不仅要关注模型层面的对齐与防御,还要关注能力开放与责任权限的边界如何划定、公共防御体系与全民安全素养如何构建,从而让智能体的技术潜力真正转化为广泛的社会收益,而不是以系统性的安全代价为前景。
Copyright ©2016 中国人民大学科学技术发展部 版权所有
地址:北京市海淀区中关村大街59号中国人民大学明德主楼1121B 邮编:100872
电话:010-62513381 传真:010-62514955 电子邮箱: ligongchu@ruc.edu.cn
京公网安备110402430004号